Mini-PCs im KI-Test: Apple vs. AMD und Intel mit lokalen LLMs - Golem.de
Ein Schreibtisch voller Mini-PCs und ein automatisierter Benchmark für lokale LLMs sind ein Fest für jeden Golem-Redakteur. 10. Oktober 2026 um 07:30 Uhr / Ein Test von Mike Faust Für den Test lokaler KI...
- 3 min read

Ein Schreibtisch voller Mini-PCs und ein automatisierter Benchmark für lokale LLMs sind ein Fest für jeden Golem-Redakteur.
10. Oktober 2026 um 07:30 Uhr / Ein Test von Mike Faust
- Mini-PCs im KI-Test: Apple vs. AMD und Intel mit lokalen LLMs
- Die sechs Testkandidaten im Überblick
- Ältere Hardware noch nicht abschreiben
Künstliche Intelligenz direkt auf dem eigenen Rechner auszuführen, wird immer interessanter. Ob als privater KI-Assistent, für die Zusammenfassung von Texten oder zur Unterstützung bei alltäglichen Aufgaben, lokale Large Language Models (LLMs) ermöglichen den Einsatz von Sprachmodellen, ohne dass dafür Cloudanbindung erforderlich ist.
Doch wie gut eignen sich kompakte Mini-PCs für diese Aufgaben? Um dass herauszufinden, haben wir sechs Mini-PCs, darunter ein aktueller Mac Mini mit M6, auf ihre Leistung mit einem automatisierten LLM-Benchmark untersucht.
Der Benchmark
Für unseren Test kommt der LLM-Benchmark von AIDatatools(öffnet im neuen Fenster) zum Einsatz. Dabei handelt es sich um ein quelloffenes Benchmark-Werkzeug, mit dem sich die Geschwindigkeit lokal ausgeführter Sprachmodelle auf unterschiedlichen Hardwarekonfigurationen messen lässt. Die Software nutzt Ollama, eine Plattform zum lokalen Ausführen von Sprachmodellen, und ermittelt, wie schnell ein Modell auf dem jeweiligen Rechner arbeitet.
Dabei wird anhand des verfügbaren Arbeitsspeichers ermittelt, welche Größen der Sprachmodelle Phi3, Gemma 2, Mistral, Deepseek-R1 und Llava auf dem jeweiligen Gerät ausführbar sind. Im Anschluss werden diese automatisch heruntergeladen und mit vorgegebenen Prompts beschäftigt. Am Ende steht für jedes Gerät und jedes Sprachmodell ein Durchschnittswert der damit möglichen Tokens pro Sekunde, um eine Vergleichbarkeit herzustellen.
Der Benchmark ist für Windows, Linux und MacOS verfügbar, und die gemessenen Werte fließen in eine öffentliche Datenbank(öffnet im neuen Fenster) ein, in der sich Ergebnisse weiterer Nutzer finden lassen. Für die Ausführung des Benchmarks in der Kommandozeile müssen auf Windows-Systemen Ollama, Python 3 und C++ installiert sein. Auf Macs reichen Ollama und Python aus.
Tokens! Tokens! Tokens!
Tokens sind die Textbausteine, in die ein Sprachmodell Eingaben und Ausgaben zerlegt. Je höher der erreichte Token-pro-Sekunde-Wert ist, umso höher ist der mögliche Durchsatz des Sprachmodells auf dem jeweiligen Mini-PC. Das ist insbesondere dann interessant, wenn ein KI-Modell längere Antworten formuliert oder umfangreiche Texte verarbeitet. Der Benchmark liefert damit einen Anhaltspunkt dafür, wie flüssig sich lokale Sprachmodelle auf einem bestimmten System nutzen lassen.
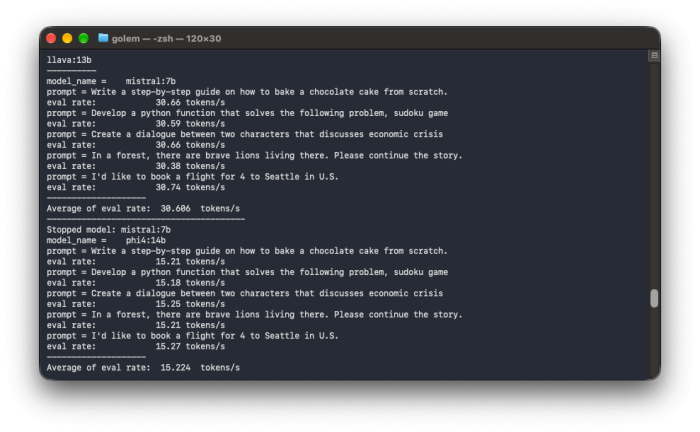
Allerdings ist bei der Interpretation der Ergebnisse auch etwas Vorsicht geboten. Die Geschwindigkeit hängt nicht allein vom Prozessor ab, sondern unter anderem auch vom verwendeten Sprachmodell, dessen Größe und Quantisierung, dem verfügbaren Arbeitsspeicher sowie der Frage, ob die Berechnungen auf der CPU oder einer dedizierten GPU ausgeführt werden. Auch das verwendete Betriebssystem und die Systemkonfiguration können das Ergebnis beeinflussen.
Wir haben uns für den Test auf die jeweils vorinstallierte Windows-11-Version mit 26H2-Update und beim Mac Mini auf das aktuelle Mac 27 Golden Gate beschränkt.
- Hier geht es zu Künstliche Intelligenz: Wissensverarbeitung bei Amazon
Wenn Sie auf diesen Link klicken und darüber einkaufen, erhält Golem eine kleine Provision. Dies ändert nichts am Preis der Artikel.